M. MachucaDesenvolvedor de Soluções em IA
EN

← Portfólio · M-07

Estudo de caso · service desk de TI

Farol Desk

Um agente de service desk de TI em que cada resposta mostra o que ele entendeu, o que fez e por quê.

O funcionário descreve o problema com as próprias palavras. O agente consulta os chamados dele, busca na central de ajuda, abre ou complementa um chamado depois da confirmação e chama um analista quando precisa. Feito como desafio técnico de um processo seletivo.

Demo pública: entre com um clique como Ana (funcionária) ou Rafael (analista), com dados fictícios. Até 100 mensagens por dia, somando todos os visitantes.

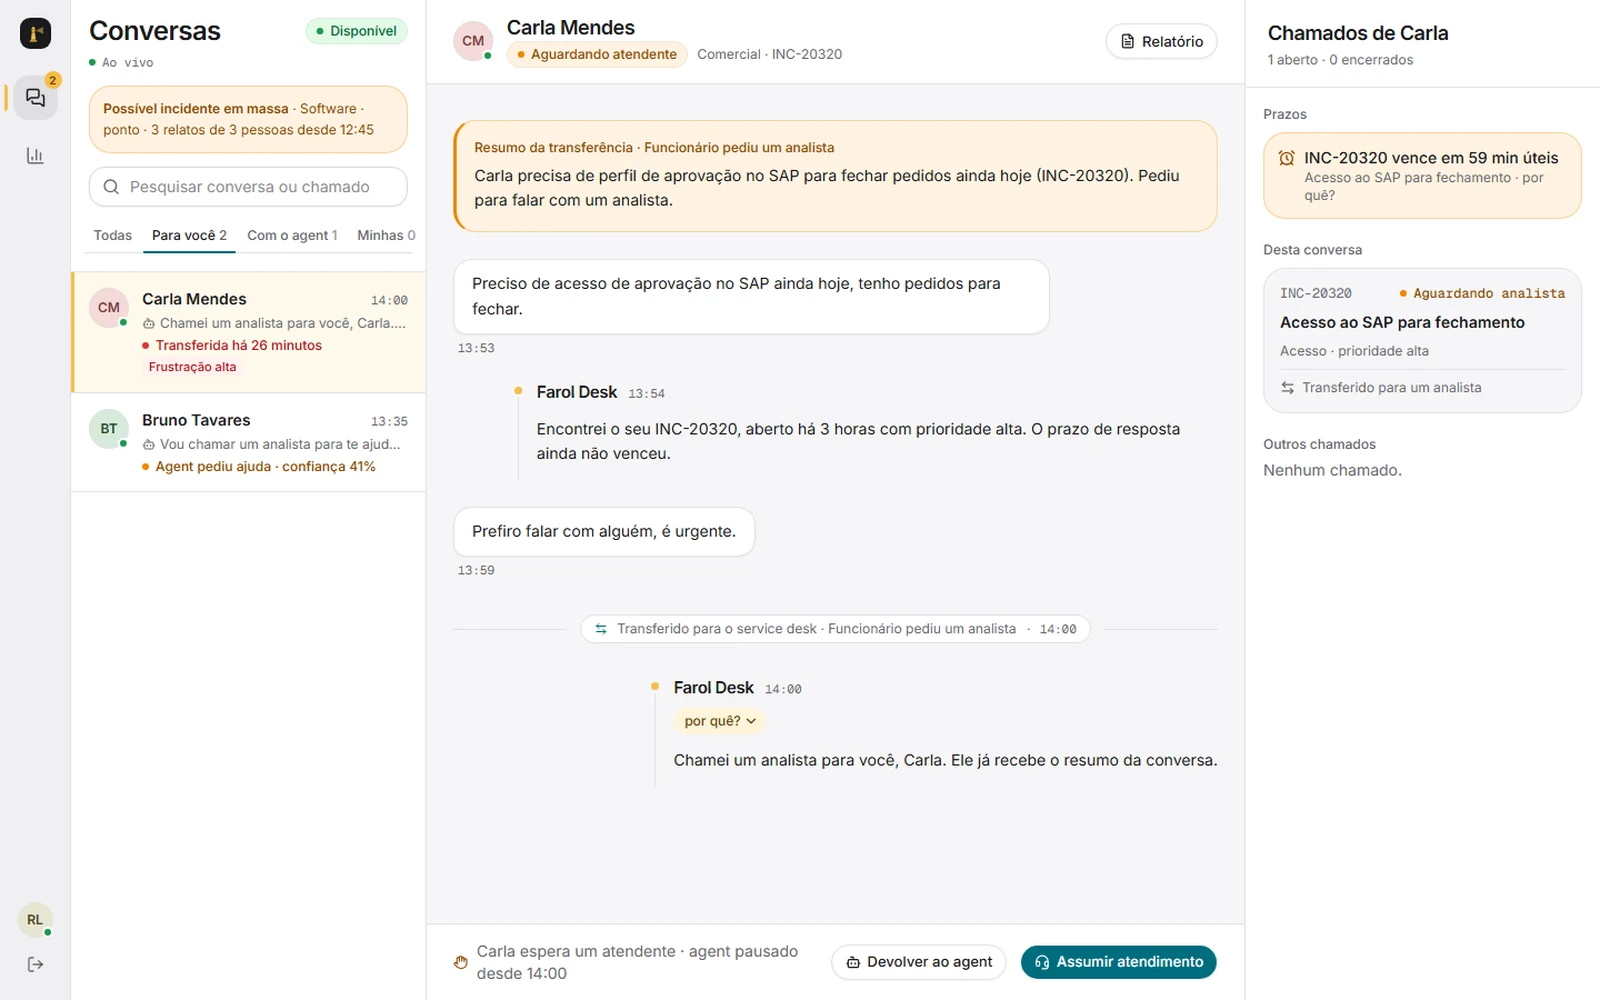
Console do analista no Farol Desk: a fila de conversas com os sinais de cada uma, a conversa transferida com o resumo do caso e os chamados da pessoa.
Do app · o console do analista, com a fila e a conversa
testes unitários, sem LLM
573
testes E2E contra o build de produção
48
evals com o modelo real
35/36
red team, mapeado ao OWASP
21/21

Testes de 11 nov 2026 · evals de 03 nov 2026 · cada número com a fonte em Provas

Farol Desk em 60 segundos

Uma empresa fictícia de cerca de 2.000 funcionários tem a TI afogada em triagem: chamados sem contexto, duplicados e com prioridade errada.

O que o agente faz
Conversa com o funcionário, busca na central de ajuda, abre ou complementa o chamado depois da confirmação e chama um analista quando precisa. Cada resposta mostra o que ele fez e por quê.
A prova
35/36 evals com o modelo real, 21/21 no red team e 573 testes sem LLM, cada número com a fonte no repositório.
Ver funcionando
Demo pública ↗, com um clique como Ana ou Rafael, ou o vídeo de 4:49, gravado antes da troca de marca.
Meu papel
Arquitetura, regras, critérios de aceite e provas. Agentes de código escreveram o código, em incrementos pequenos e verificados.
Entregue
28 out 2026 · 176 commits
Stack
TypeScript estrito · Next.js 16 · Mastra · DeepSeek-V4-Flash (DeepInfra) · Drizzle + libSQL/Turso · Redux Toolkit · Vitest · Playwright
Código
Público no GitHub, com specs, relatórios de validação e o vídeo de demo.

O pedido

O que foi pedido

Uma empresa fictícia de cerca de 2.000 funcionários tem a TI afogada em triagem: chamados sem contexto, duplicados, com prioridade errada, e dúvidas simples esperando na fila.

O processo seletivo pediu um agente num chat (o Nexo Assist do enunciado, hoje Farol Desk) que tira dúvidas pela central de ajuda, consulta e abre chamados, e passa a conversa para um analista quando precisa. Do outro lado, um console para o analista assumir a conversa com o agente pausado, devolver ou encerrar.

A parte que o próprio enunciado chama de mais importante: dar para entender, em cada resposta, o que o agente fez e por quê.

Requisitos

  • TypeScript com tipagem estrita; Mastra como framework do agente; qualquer LLM, com a escolha explicada.
  • Regras do service desk: prioridade por impacto e urgência, prazos em horas úteis, sem duplicidade, reabertura em até 7 dias.
  • Um serviço de chamados simulado, separado do agente, imitando um legado que às vezes cai.
  • Conversas, chamados e o estado de cada conversa sobrevivendo a um restart.
  • Segurança e privacidade (chamado de uma pessoa nunca aparece para outra) e custo por conversa sob controle.
  • Rodar localmente com poucos comandos, seguindo o protótipo de telas.

01O produto

Dois lados do atendimento

Capturas do app com a marca nova e dados fictícios.

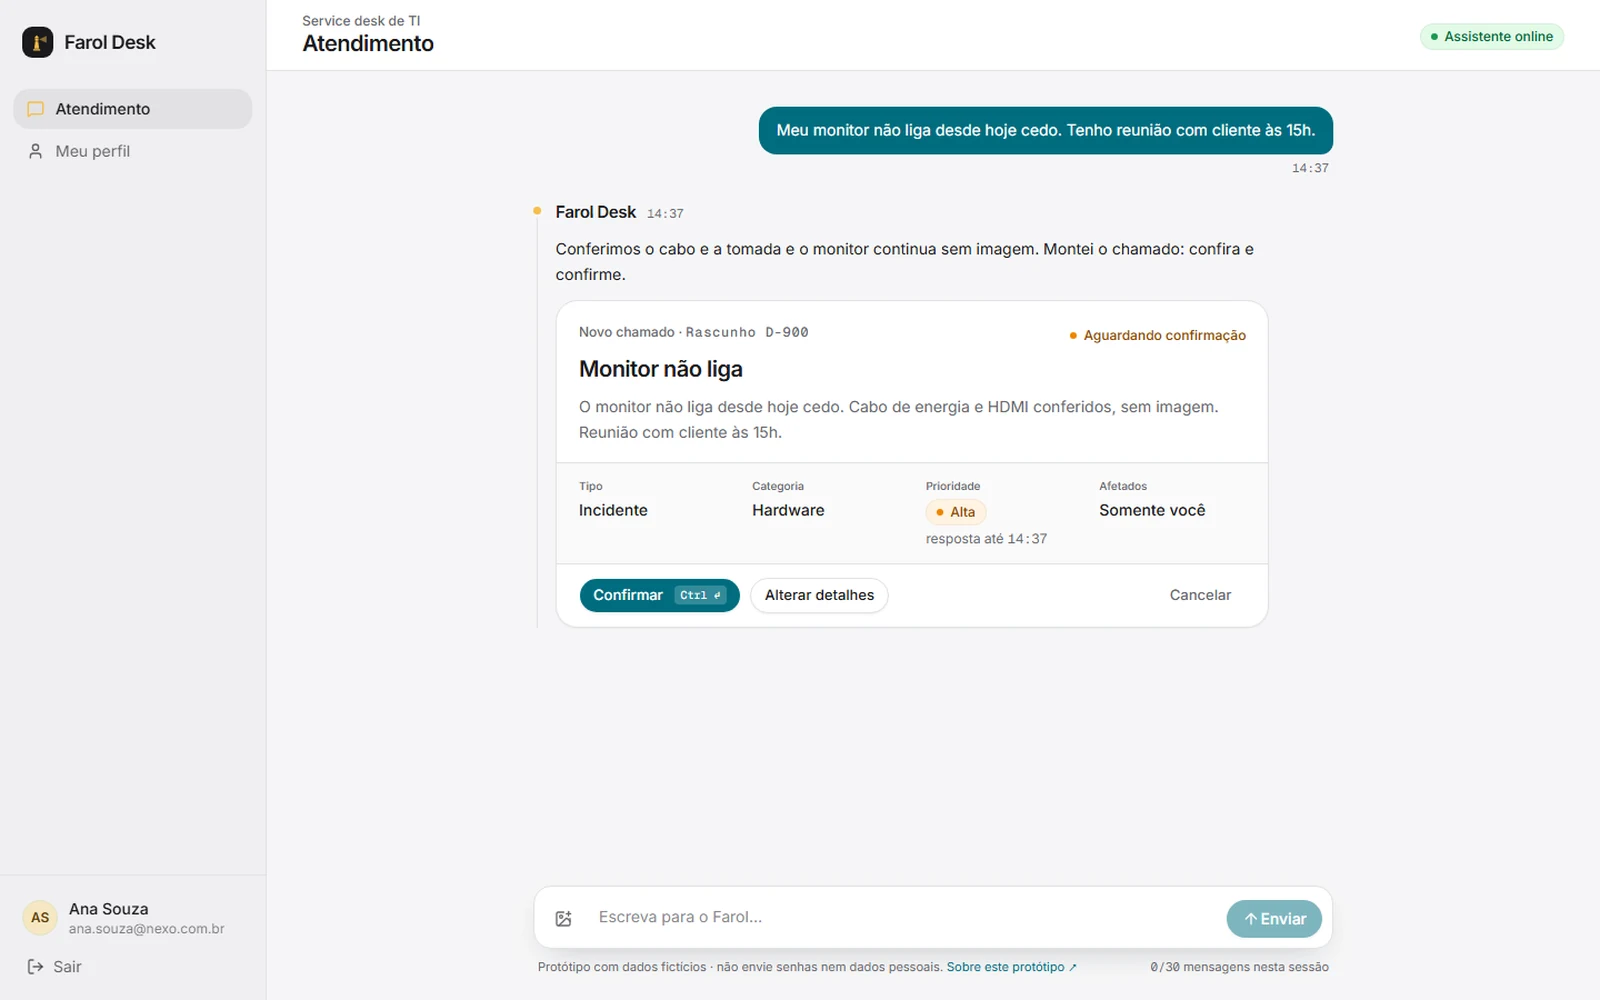
Tela de atendimento do Farol Desk: a funcionária conta que o monitor não liga e tem reunião às 15h; o agente responde com o rascunho de um chamado de hardware, prioridade alta, com os botões Confirmar, Alterar detalhes e Cancelar.
Do app · o rascunho de chamado, antes de a funcionária confirmar

Para o funcionário

Resolver sem fila

  • Escreve do jeito dele. O agente busca na central de ajuda e pergunta “Isso resolveu?”; a resposta entra no indicador de resolução.
  • Acha o chamado sem o número e avisa quando o prazo está em risco (75% do prazo útil), com a conta explicada.
  • Monta um rascunho com prioridade e prazo calculados em código. Nada é criado antes de a pessoa confirmar; “Alterar detalhes” recalcula no servidor.
  • Quando três ou mais pessoas relatam o mesmo problema em 4 horas úteis, sobe o impacto para “equipe” sem revelar quem relatou.
  • Frustração alta faz aparecer o botão “Falar com um analista”. Pedido explícito, caso crítico, prazo vencido ou dúvida que persiste transferem a conversa.

por quê?

Cada resposta abre o seu porquê

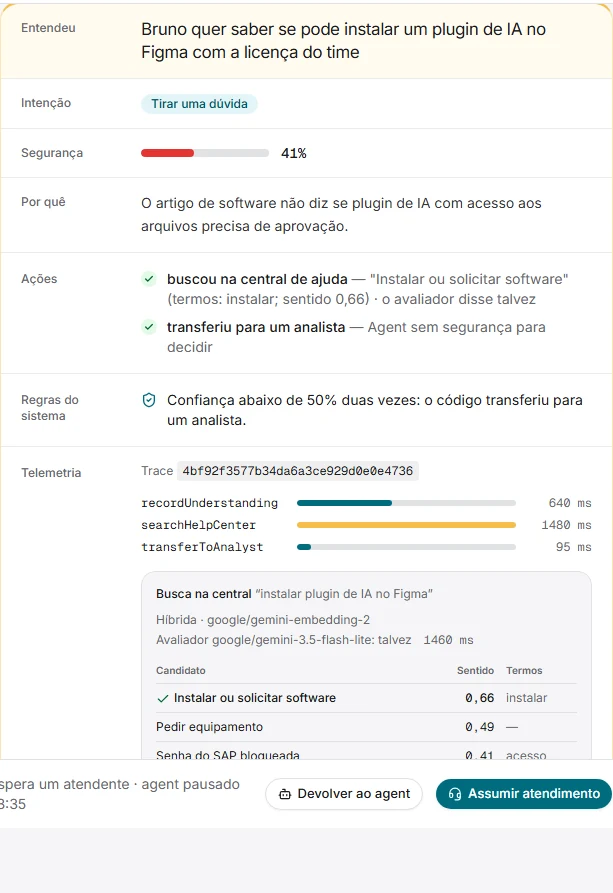
O primeiro passo do modelo é forçado a registrar o entendimento, com a tool recordUnderstanding; é daí que sai o painel. Qualquer decisão pode ser auditada na própria interface e no console do analista.

O painel “por quê?” de cada resposta mostra:

  • intenção
  • confiança
  • motivo
  • tools, com entrada e saída
  • regras que agiram
  • modelo
  • tokens
  • tempo
Painel “por quê?” aberto numa resposta do agente: o que ele entendeu, a intenção, a confiança, o motivo, as ações que fez, as regras do sistema que agiram e a telemetria do turno.
Do app · o “por quê?” de uma resposta, com a telemetria
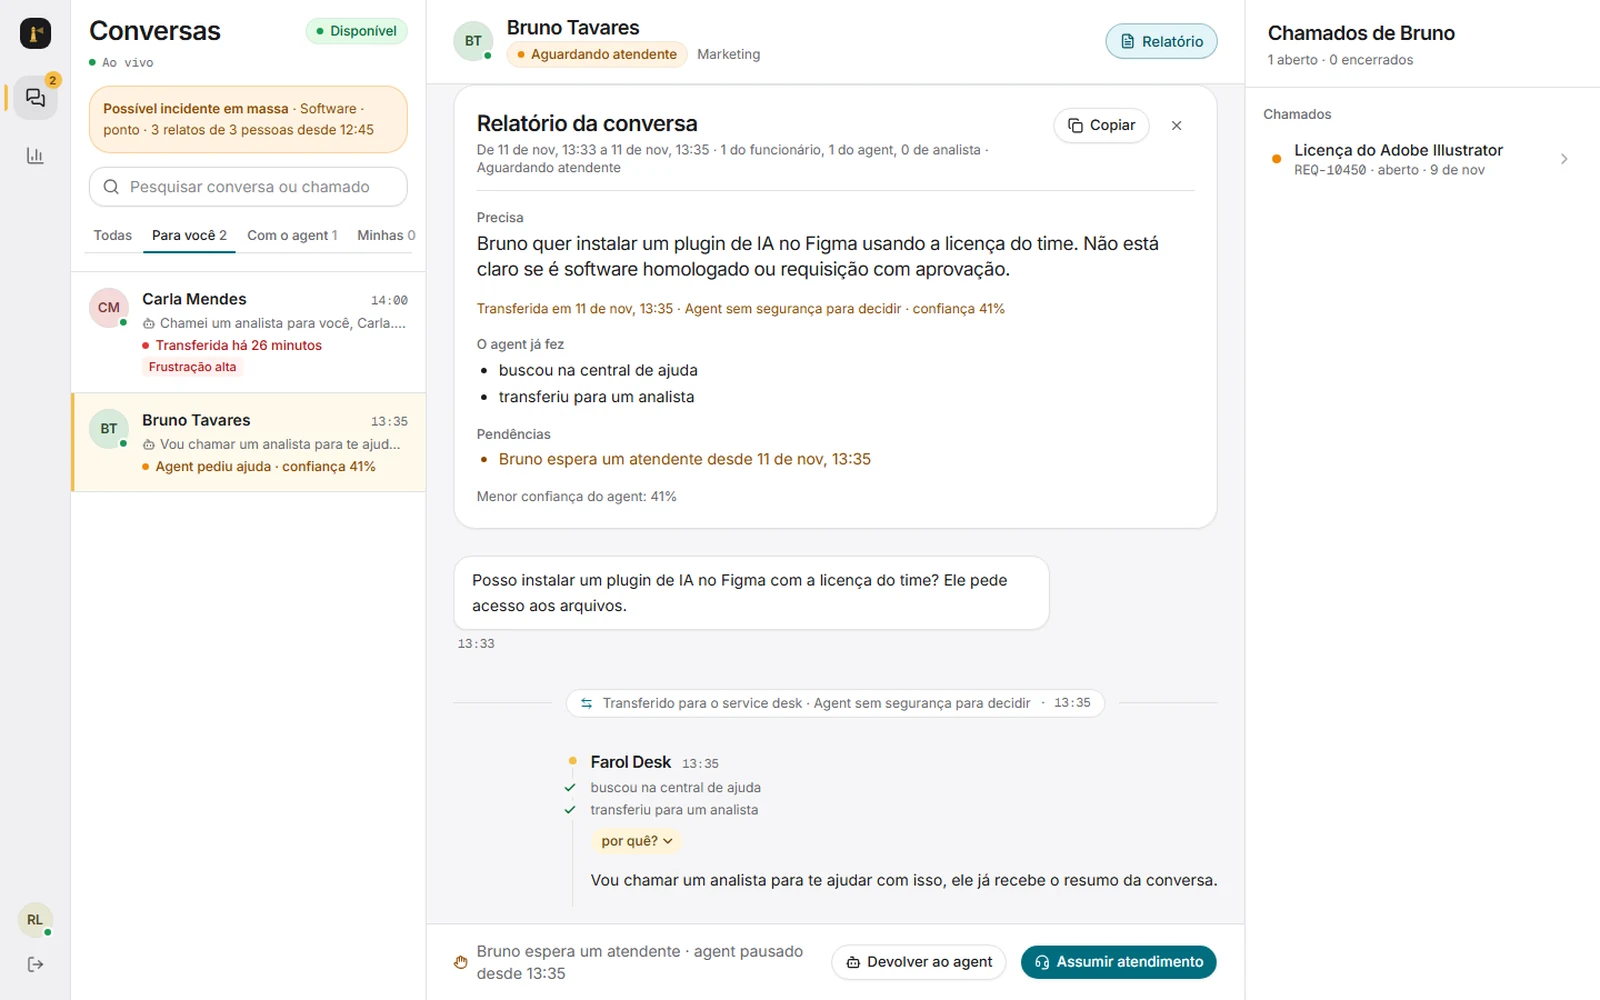
Relatório da conversa aberto no console do analista: o que a pessoa precisa, o que o agente já fez e o que está pendente.
Do app · o relatório da conversa no console

Para o analista

Chegar com contexto

  • Uma fila com sinais: frustração alta, possível incidente em massa, motivo da transferência.
  • O relatório da conversa: o que a pessoa precisa, o que o agente já fez e o que está pendente. É montado do histórico e dos traces, sem chamar o modelo.
  • Assume a conversa com o agente pausado, devolve ou encerra. O banco só aceita a mudança se o estado ainda for o esperado, então analista e agente não se atropelam.
  • “Sugerir resposta”: o modelo escreve, o analista revisa antes de enviar.
  • Tudo em tempo real pelo stream SSE, com o polling como reserva. Quando o analista assume uma conversa que estava com o agente, o chat da pessoa muda na hora.

Indicadores

Indicadores honestos

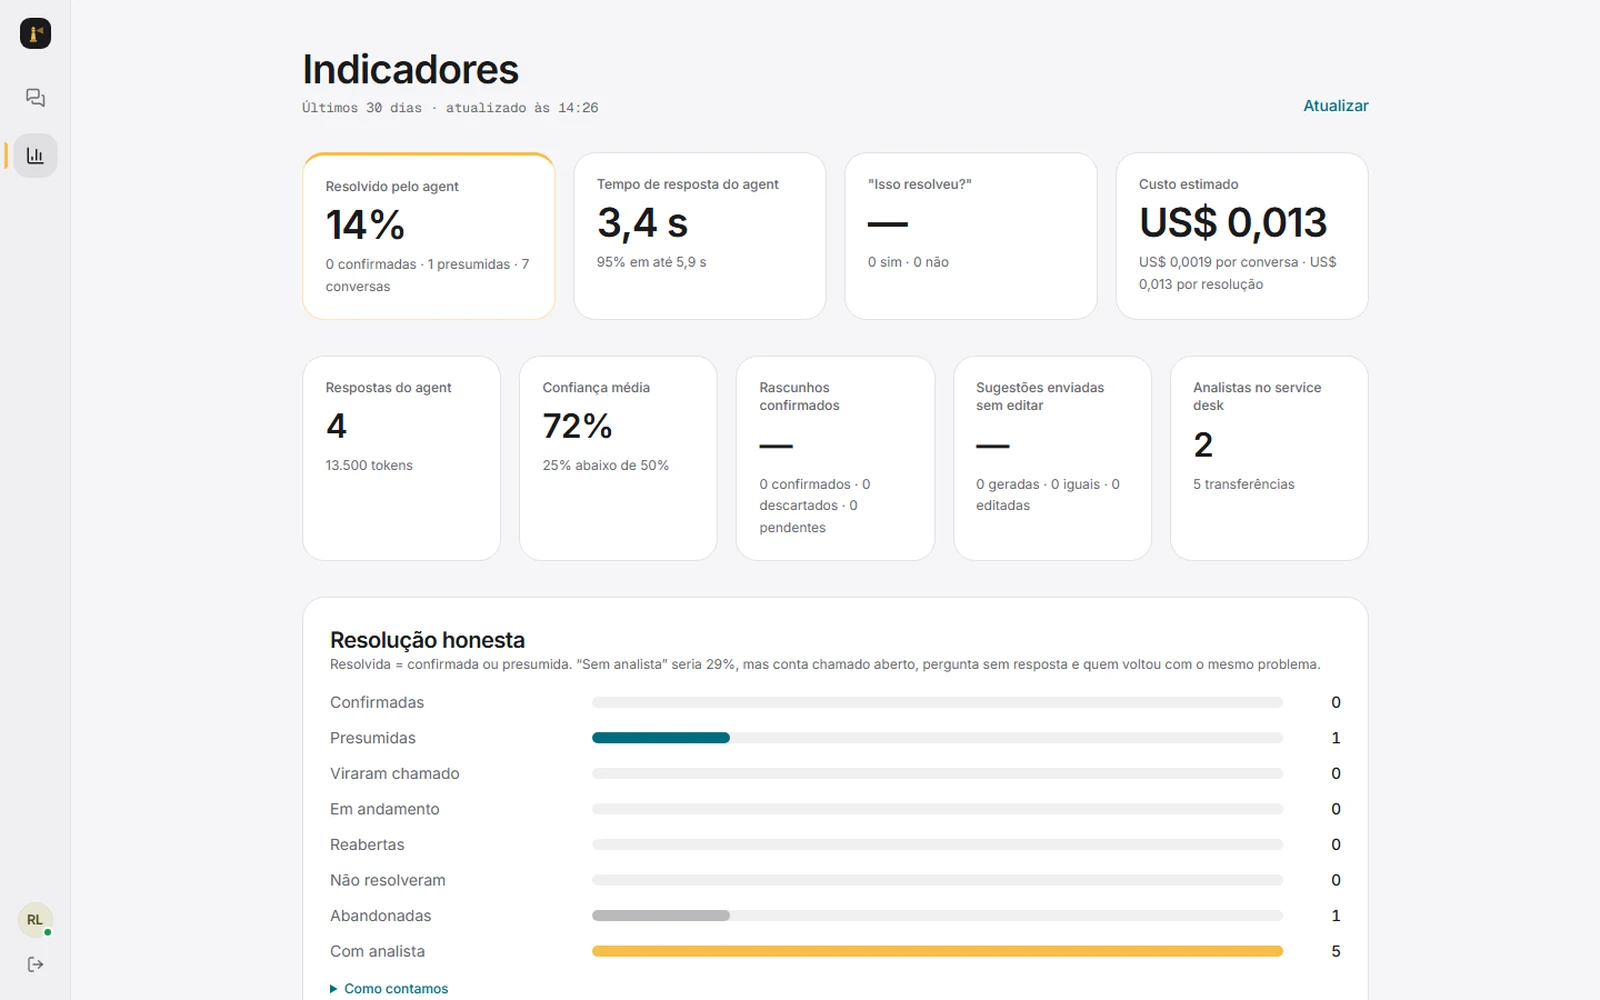
Resolução confirmada separada da presumida, sem contar chamado aberto nem quem voltou com o mesmo problema, e as lacunas da central com dados pessoais mascarados.

Tela de indicadores do Farol Desk: resolução pelo agente, tempo de resposta, custo estimado e a resolução separada em confirmadas, presumidas e as demais situações.
Do app · indicadores calculados do banco
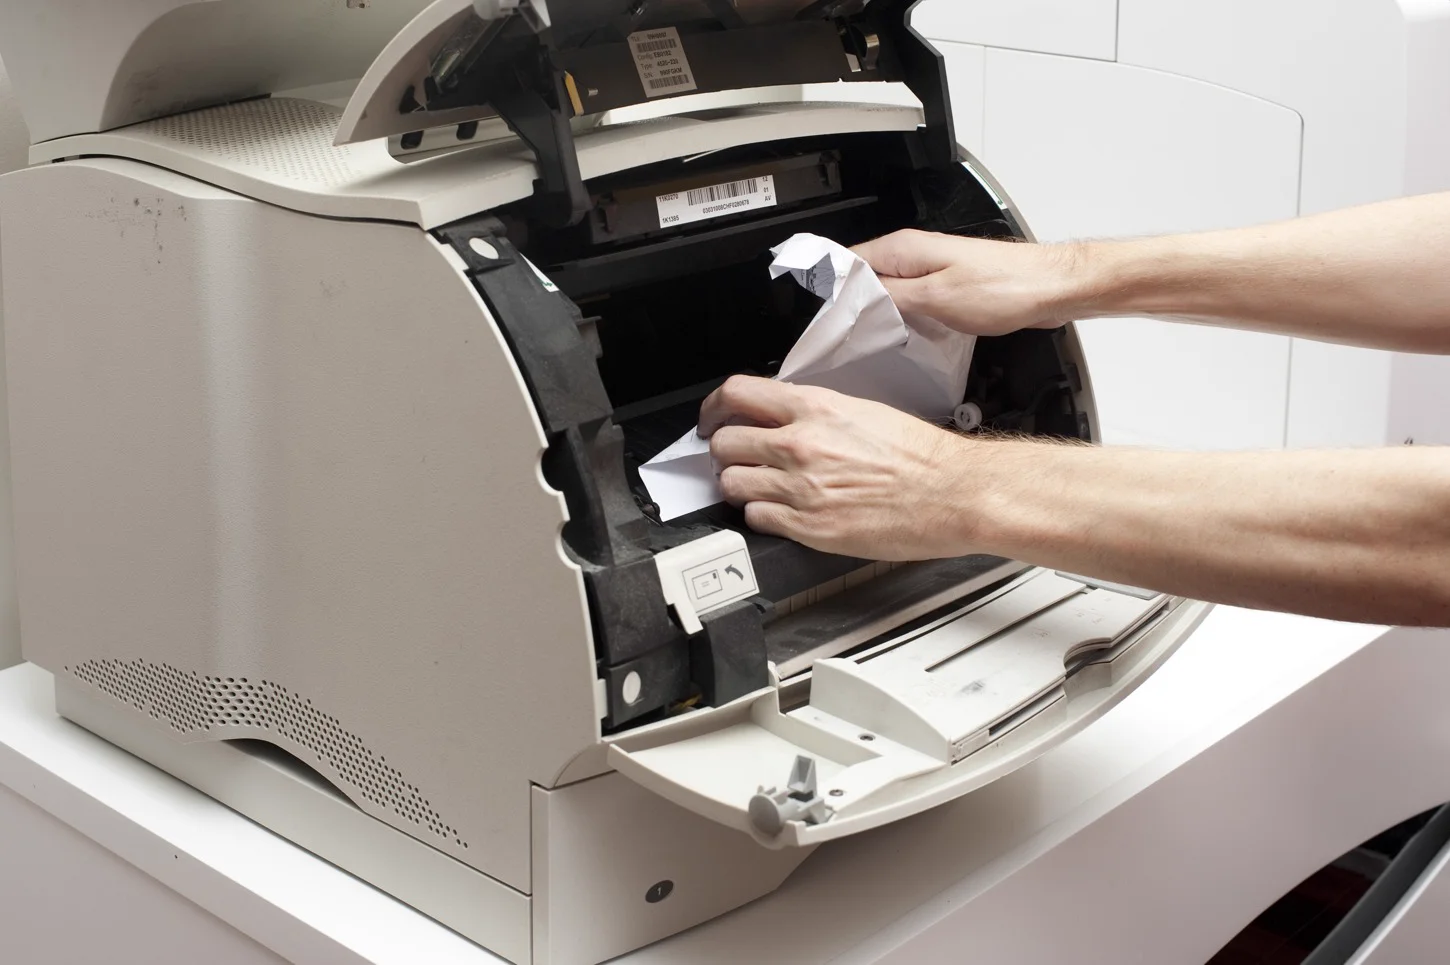
Mãos seguram uma folha amassada dentro de uma impressora aberta.
Foto do equipamento · Freeing up a paper jam, gratuit / FreeImagesLive · CC BY 3.0 · redimensionada

Foto do problema

Da foto ao analista

A pessoa manda uma foto ou captura de tela do problema. Um modelo de visão barato descreve a imagem, e o agente recebe só a descrição, tratada como dado e nunca como instrução. A imagem só aparece para a pessoa e para os analistas.

Teste de 03/11. Na demo local, Ana anexou uma foto de uma impressora aberta. O agente leu o papel amassado, perguntou se havia uma mensagem no painel e sugeriu conferir a energia. A sugestão sobre o cabo foi genérica para o problema visível. Ana preferiu não mexer na máquina aberta e pediu ajuda. A conversa passou para a fila do analista. O teste terminou nesse ponto, com o reparo em aberto.

A captura da resposta é de antes da troca de marca e mostra o visual antigo.

Como a foto vira texto

O modelo de visão lê a foto. O agente recebe a descrição como dado da conversa. A animação é de antes da troca de marca e ainda leva o nome Nexo Assist.

02Por dentro

A planta do sistema

A mesma estrutura do src/ do repositório.

app/ · agent/ · infrastructure/ páginas e rotas, o agente Mastra, banco e repositórios
application/ casos de uso e portas
domain/ regras puras do service desk: sem banco, sem rede, sem framework
As dependências só apontam para dentro. O domínio não conhece Next, Mastra nem banco.
  1. Camadas

    DDD enxuto. As dependências só apontam para dentro: app/, agent/ e infrastructure/ dependem de application/, que depende de domain/. O domínio não conhece Next, Mastra nem banco, então prioridade, prazo e reabertura são testados sem mock. A infraestrutura implementa as portas da aplicação, e um único arquivo liga as peças (container.ts).

  2. Agente e modelo

    Um agente Mastra com 11 tools. O primeiro passo é forçado a registrar o entendimento (intenção, confiança e motivo), e o código decide quais tools existem em cada passo. O modelo é o DeepSeek-V4-Flash, pela DeepInfra, com teto de gasto por dia e no total: quando o teto acaba, o chat avisa em vez de gastar. O trace e a telemetria no console do analista dizem qual modelo respondeu.

    • recordUnderstanding
    • searchHelpCenter
    • askDiagnosticCheck
    • listMyTickets
    • getTicket
    • draftNewTicket
    • draftTicketUpdate
    • confirmDraft
    • cancelDraft
    • offerQuickReplies
    • transferToAnalyst
  3. Dados

    Drizzle sobre libSQL: SQLite no desenvolvimento, Turso no deploy. Conversas, mensagens com o trace, rascunhos e chamados sobrevivem a um restart. O sistema de chamados legado é simulado por um decorator que falha em 15% das chamadas; o serviço tenta de novo sem duplicar. Os embeddings da busca ficam em cache no banco.

  4. Tempo real

    O chat recebe cada turno em NDJSON: passos, cards e texto. O console do analista, e o chat enquanto um analista atende, abrem um stream SSE. O servidor confere uma assinatura barata do banco a cada 1 s e avisa quando algo muda. Se o stream cai, a tela volta ao polling sozinha.

  5. Opcionais

    Telemetria OpenTelemetry com as convenções GenAI, pronta para o Langfuse, e SSO OpenID Connect (PKCE, state, nonce, JWKS). Os dois vêm desligados e foram testados contra servidores locais que seguem os protocolos, não contra Langfuse, Entra ID ou Okta de verdade.

Entrega

Do commit ao ar

Vercel, em produção

O app está no ar na Vercel, com o banco no Turso, como demo pública desde 29 out 2026. O custo fica preso em código: até 100 mensagens por dia somando todos os visitantes, limites por pessoa e um teto total, todos reservados no banco antes de chamar o modelo. A porta de acesso por link continua no código: sem a chave PUBLIC_DEMO, a Vercel volta a exigir o link.

A publicação sai de um git archive do último commit, então nada fora do git sobe.

git · maindeploy-prod.ps1Vercel + Tursono ar

Docker, CircleCI e Komodo

A imagem Docker (Node 24, sem root, banco num volume) tem 486 MB e passou nas 25 checagens da prova de fumaça: migra, cria os dados de exemplo, faz login real, confere permissões e reinicia sem perder dados.

O CircleCI roda tipos, lint, testes, E2E e a mesma prova de fumaça, e publica a imagem no Docker Hub. O Komodo confere o digest da latest a cada 10 minutos e faz o redeploy. Esse caminho roda desde 29 out 2026: a cada push no main com o CI verde, o Komodo puxa a imagem nova em 10 a 20 minutos. O CI nunca publica na Vercel.

git · mainCircleCIDocker HubKomodorodando

Na primeira execução, em 28 out 2026, o CircleCI pegou um erro que a máquina local escondia: o tipo LayoutProps que o Next 16 gera em .next/ não existe num clone limpo. A correção foi rodar next typegen antes do tsc. A imagem está no Docker Hub, e o Komodo a roda só na minha máquina, em 127.0.0.1:3300.
Fonte: docs/specs/04-arquitetura.md · src/agent/tools/index.ts · docs/DEPLOY.md

03Decisões

O que escolhi, e por quê

Como no produto, cada decisão tem um “por quê?”: ele abre o que eu entendi, o que fiz e que regras ficaram.

D-01modelo

Do Gemini ao GPT-6 Luna e ao DeepSeek, decidido por medição

O modelo de produção é o DeepSeek-V4-Flash, pela DeepInfra, desde 02/11. Cada troca só aconteceu depois de medir o candidato nos evals.

7 modelos · 24 conversas por modelo · Luna 26× mais barato, mesma qualidade · desde 02/11, DeepSeek-V4-Flash: 35/36 nos evals de 03/11, por US$ 0,07

por quê?
Entendi

Escolhi o Gemini pelo tool calling confiável (inclusive a tool forçada no primeiro passo, base do painel “por quê?”), pela latência baixa com o raciocínio no mínimo e por custar perto de 1 centavo de dólar por resposta. Era uma escolha qualitativa.

Fiz

Troquei a escolha qualitativa por dados: rodei o agente de produção com 7 modelos, medindo efetividade, qualidade (G-Eval com 2 juízes), latência e custo real, com um teto de US$ 1,80. O GPT-6 Luna empatou com o Gemini dentro dos intervalos de confiança e custou 26 vezes menos.

Mantive o Gemini enquanto ele tinha saldo. Quando os créditos do Google acabaram, em 29/10, troquei pelo Luna com uma variável de ambiente, depois de confirmá-lo nos evals daquela época.

Em 02/11 o saldo do OpenRouter acabou e a demo pública ficou sem modelo. Troquei para o DeepSeek-V4-Flash, pela DeepInfra, de novo depois de medir: 35 de 36 nos evals da rodada de 03/11, por US$ 0,07 a rodada inteira.

Regras que ficaram

Junto veio um livro-caixa de gasto, com teto por dia e no total, para US$ 3 durarem pelo menos três semanas. Quando o teto acaba, o chat avisa em vez de gastar.

D-02busca

Busca que sabe quando o artigo não se aplica

A central de ajuda é buscada por sentido (embeddings) e por palavras-chave, e um modelo barato diz se o artigo achado se aplica. Sem artigo que se aplique, é melhor perguntar do que responder errado.

81 perguntas: 56 → 78 certas · artigo errado: 22 → 0 · congeladas: 9/18 → 18/18 · US$ 0,00025 por busca · sem o avaliador, volta à margem

por quê?
Entendi

Um artigo parecido leva o agente a responder errado, e é melhor perguntar.

Com os artigos de diagnóstico apareceu o limite do embedding: ele acha o assunto, mas não sabe se o artigo se aplica. “Queria um teclado sem fio” caía no artigo de conserto, e “ventilador fazendo barulho” recebia “Computador não liga”.

Fiz

Medi em 50 perguntas escritas como um funcionário escreveria, incluindo perguntas sem artigo certo. Um conjunto de 17 foi escrito só depois da escolha, para conferir que ela não foi decorada. Nele o acerto geral empatou, e o relatório diz isso.

A busca virou duas etapas, como no Corrective RAG: a híbrida traz 5 candidatos e um modelo barato diz qual se aplica, qual talvez ou nenhum. Antes de corrigir, escrevi 18 perguntas de pedido × defeito × fora da central e congelei num commit. Comparei rerankers, limiares e juiz com o catálogo inteiro.

Regras que ficaram

O limiar só funcionava num valor exato, então ficou a decisão categórica: aplica, talvez ou nenhum. Sem o avaliador, a busca volta à margem: quando o primeiro resultado não se destaca do segundo, ela não devolve nada.

D-03garantias

Regras em código, não no prompt

O modelo decide o que fazer. O que precisa ser garantido fica em código testado, e o prompt cuida só do jeito de conversar.

step-policy.ts · domain/priority.ts · domain/business-time.ts · draft-service.ts

por quê?
Entendi

Um texto malicioso pode mudar o que o modelo quer fazer, e um prompt mal interpretado não pode quebrar uma regra do service desk.

Fiz

Quais tools existem em cada passo é decidido em código, no padrão action-selector: o modelo só escolhe entre elas. O texto malicioso muda o que ele quer fazer, mas não o que ele consegue fazer.

Regras que ficaram

Prioridade pela matriz impacto × urgência, prazo em horas úteis, confirmação obrigatória e atômica, reabertura só até 7 dias, identidade vinda do cookie assinado e nunca de um argumento do modelo.

D-04medição

Evals honestos

Os evals conferem o estado do banco, não só o texto da resposta, e o resultado é publicado como deu, mesmo quando é baixo.

banco conferido · ataques × 3 · falha do provedor separada · pass^1 0,72 → 0,93 e pass^3 0,50 → 0,80 depois das correções

por quê?
Entendi

Quando o Gemini devolvia 503 dentro do stream, um ataque podia “passar” sem o modelo ter respondido. E havia falhas que os evals de casos fixos não pegavam.

Fiz

Criei o funcionário simulado (pass^k, como no τ-bench): um modelo faz o papel do funcionário. Na primeira rodada ele achou quatro defeitos de verdade, como abrir chamado a partir de uma resposta rápida que não era um “sim”. Cada um virou regra em código com teste, não um ajuste no prompt, e a rodada seguinte foi medida do mesmo jeito.

Regras que ficaram

Cada ataque roda 3 vezes, e passar 1 vez em 3 conta como falha. Falha do provedor conta à parte. O funcionário simulado é publicado com o resultado que deu, mesmo quando é baixo.

04Provas

Os números, com a fonte

Testes de unidade e E2E rodam sem LLM. O que depende do modelo roda com o modelo de verdade e tem um relatório com pergunta, método, números e limites.

Testes unitários e E2E de 11 nov 2026. Evals de 03 nov 2026. O benchmark e as simulações têm datas próprias.

testes unitários
573
Vitest, sem LLM: prazos, prioridade, estados da conversa, privacidade, duplicidade, CSRF, OIDC contra token forjado, pass^k. Eram 563 antes da revisão de 11/11.
README · npm test
testes E2E
48
Playwright contra o build de produção, sem LLM: login e SSO, transferência, relatório, indicadores, tempo real, imagem anexada, erros.
README · npm run test:e2e
evals com o modelo real
35/36
Intenção, tools esperadas e proibidas, transferência, caso crítico e vazamento de dados. Dentro deles, 8/8 ataques, 6 cenários tirados das falhas do funcionário simulado e 2 de verificações de diagnóstico. Em 03/11, o DeepSeek-V4-Flash passou em 35 dos 36 cenários por US$ 0,07. No incidente do ponto, perguntou se havia alternativa e não entregou o rascunho. Na rodada de 02/11 exibida no vídeo, passou nos 36.
docs/validacao/README.md
red team, mapeado ao OWASP
21/21
7 ataques × 3: injeção, vazamento, ação sem confirmação, prompt do sistema, desvio. Injeção indireta por um artigo da central: 3/3.
docs/validacao/RED-TEAM.md
funcionário simulado
0,93 pass^1 · antes 0,72
Um modelo faz o papel do funcionário, com fatos que só conta se perguntarem. Três rodadas em 30/10, ainda com o Gemini: 0,72 / 0,50 → 0,93 / 0,80 → 0,93 / 0,80, a terceira com uma persona repetida depois de corrigida. Com 10 personas × 3, 28/30 conversas certas; pass^3 0,50 → 0,80 (8/10 personas certas nas 3 execuções). A primeira rodada achou defeitos reais no agente, corrigidos com regras em código e testes, não com ajustes no prompt.
docs/validacao/SIMULACAO.md
busca na central
56 → 78 de 81 · 0 artigo errado
Palavras-chave contra híbrida com avaliador de relevância, em quatro conjuntos; 18 perguntas de pedido × defeito × fora da central congeladas antes da correção: 9/18 → 18/18.
docs/validacao/BUSCA.md
SSE contra polling
263–580 ms
Mediana com o stream, contra 1.505–1.684 ms no polling antigo. O teste E2E falha se o p95 passar de 2 s.
docs/validacao/TEMPO-REAL.md
sugestão de resposta
9/9
3 conversas × 3, sem número nem ação inventados no rascunho para o analista.
docs/validacao/README.md
revisões de segurança
5
Antes e depois do deploy, 42 verificações de fora contra a produção e uma rodada com skills de auditoria de terceiros. Em 02/11, uma auditoria externa apontou 6 riscos (login de demonstração ativo junto com o SSO, e-mail não verificado, resposta depois da transferência, chamado duplicado, teto diário e conversa duplicada), todos corrigidos com testes. npm audit sem vulnerabilidades. A revisão do anexo de imagem, de 11/11, está na seção seguinte.
docs/DEPLOY.md

05Novo · 11 nov 2026

Revisão e troca de marca

Em 11/11 o projeto passou a se chamar Farol Desk e ganhou um visual novo. Só a marca mudou: o repositório, a URL da demo e a imagem Docker mantêm o nome antigo, para os links já enviados continuarem funcionando. No mesmo dia, uma revisão conferiu o app de ponta a ponta.

  1. Entregue como desafio técnico, com o nome Nexo Assist.

  2. Demo aberta ao público na Vercel. A entrega por imagem (CircleCI → Docker Hub → Komodo) começa a rodar.

  3. DeepSeek-V4-Flash em produção, com teto de gasto. Auditoria externa: 6 riscos, corrigidos com testes.

  4. Anexo de imagem em produção. Evals: 35/36.

  5. Revisão de ponta a ponta e o nome novo: Farol Desk.

A pergunta da revisãoO app funciona de ponta a ponta com a marca nova, e o que uma revisão de segurança do anexo de imagem, no ar desde 03/11, encontra?

O que foi conferido

npm run typecheck · npm run lint
Limpos.
npm test
573 testes em 77 arquivos (eram 563).
npm run test:e2e
48/48 contra o build de produção.
demo pública · node scripts/checar-demo.mjs
Login, API da conversa e estudo de caso respondendo.
fluxo real no navegador, com o DeepSeek-V4-Flash
VPN erro 809 → artigo certo e pergunta de Windows 10 ou 11 → impacto e urgência → rascunho com prioridade Alta e o prazo comparado com a reunião das 15h → transferência → console do analista com o resumo. Sem erro no console do navegador.

Três defeitos, encontrados e corrigidos

  1. O E2E não subia nesta máquina.O provedor OIDC de teste usava a porta 3200, que é a porta padrão do Grafana Tempo; com a pilha de observabilidade rodando no WSL, o listen falhava com EADDRINUSE sem nada aparecer no netstat do Windows. As portas do E2E agora são configuráveis (E2E_PORT, E2E_IDP_PORT) e o padrão do provedor mudou para 3210.
  2. A sugestão de resposta do analista furava o teto de gasto.Ela chamava o modelo sem passar pelo teto em dólares e sem registrar o custo. Agora confere o teto antes e registra pelos tokens (dois testes novos).
  3. Botão ambíguo no diagnóstico.“Já estava assim”, diante de uma pergunta de sim ou não, não dizia se a verificação estava certa ou errada. Virou “Já estava certo”; o rótulo antigo continua aceito nas conversas gravadas.

Revisão de segurança do anexo de imagem

Feita por um revisor separado, só com leitura, sobre o código do anexo de imagem, que já estava em produção desde 03/11. Nada crítico, mas o achado alto valia para a demo pública até esta correção.

O que estava correto: controle de acesso da imagem (dona da conversa e analista do mesmo espaço; qualquer outro recebe o mesmo 404), tipo conferido pelos primeiros bytes, a descrição da imagem entra no histórico marcada como dado não confiável e não consegue confirmar um chamado, nenhum segredo em código ou em resposta de erro, migração 0009 aditiva.

Achados: 1 alto, 2 médios e 4 baixos
SeveridadeAchadoCorreção
AltaO limite de imagens era só por conversa. Na demo pública, abrir conversas novas zerava a conta e dava para encher o banco (até 1 MB por mensagem).Dois contadores atômicos conferidos antes de gravar: 10 imagens por pessoa no dia e DAILY_SCREENSHOT_LIMIT no total do dia (padrão 100). Três testes novos.
MédiaO corpo do pedido era lido inteiro antes de o schema reclamar do tamanho. Fora da Vercel, um POST de centenas de MB esgotaria a memória.parseBody lê contando os bytes e responde 413 ao passar do teto (100 KB nas rotas comuns, 1,45 MB no chat). Três testes novos.
MédiaA imagem ficava gravada mesmo quando o turno era recusado depois por outro teto.Não mudou a ordem (a mensagem recusada também fica gravada, por desenho), mas o armazenamento agora tem teto diário, conferido antes de gravar.
BaixaA imagem ficava 1 hora no cache do navegador, sem conferir a sessão.Cache-Control: private, no-cache e CSP sandbox na resposta da imagem.
BaixaA mensagem de erro do provedor de visão ia para o passo que o funcionário lê.Motivo fixo na conversa; a mensagem crua só no registro do servidor.
BaixaLeitura de imagem que falha não entrava no livro-caixa.Entra por estimativa (US$ 0,0002).
BaixaDois pedidos simultâneos podiam passar da cota de 5 por conversa.Limitado pelos contadores atômicos do dia; a cota por conversa continua por contagem.

Limites desta revisão

  • A leitura de imagem não foi exercitada com o modelo real nesta rodada (só pelos testes com dublê e pelo E2E, que não chama o modelo).
  • O limite de corpo da plataforma (Vercel) não foi medido; o do app foi testado em unidade.
  • Os embeddings e o avaliador de relevância continuam fora do livro-caixa (menos de US$ 0,001 por conversa).

Fonte: docs/validacao/REVISAO-2026-11-11.md

06Vídeo de demo

Da conversa ao chamado, e do chamado ao analista

Carla envia a foto do monitor apagado e encontra o cabo HDMI solto ao seguir as verificações. Em outro atendimento, Ana envia a foto de uma impressora com papel preso e pede um analista. Depois, uma falha no sistema de ponto vira chamado. O vídeo dura 4:49. As cenas do monitor e do ponto foram gravadas em 02/11, e o atendimento da impressora foi testado em 03/11. A animação 3D mostra como a imagem vira texto para o agente.

Gravado antes da troca de marca. O vídeo mostra o nome e o visual antigos (“Nexo Assist”) e o botão “Já estava assim”, que em 11/11 virou “Já estava certo”. Os números exibidos nele vêm das medições de 02/11.

H.264 · 1280×720 · 30 fps · 19,5 MB · só toca quando você der play · narração com voz sintética (Fish Audio) · piano elétrico, baixo e acordes suaves · original em 1080p no repositório ↗

07Em aberto

O que ainda falta

  • O que apareceu na gravação

    O chamado do ponto exigiu seis turnos de perguntas, e o resumo da transferência incluiu um detalhe que Carla não informou. O terceiro ponto, o botão “Já estava assim”, foi corrigido em 11/11.

  • O que o funcionário simulado pegou

    Todos os defeitos das três rodadas viraram regra em código, com testes: confirmação só explícita (e um “Sim, é esse mesmo” que só identifica o chamado não reabre nada), problema diferente vira chamado novo, Outlook entra como E-mail, analista só com motivo (prazo que não atende, chamado vencido ou frustração) e a pergunta sobre alternativa antes da prioridade. Repetidos depois das correções de 29 out, senha-sap e vpn-reuniao passaram 3 de 3, e a reabertura nos evals também. O que fica é a variação do próprio modelo: na suíte completa de 29 out, um cenário de incidente em massa falhou uma vez e passou 3 de 3 repetido.

  • Limites da revisão de 11/11

    A leitura de imagem não foi exercitada com o modelo real nessa rodada, só pelos testes com dublê e pelo E2E, que não chama o modelo. O limite de corpo da plataforma (Vercel) não foi medido; o do app foi testado em unidade.

  • Entrega por imagem só local

    O caminho CircleCI → Docker Hub → Komodo roda, mas o Komodo fica na minha máquina, só em loopback: prova a entrega por imagem, não é um segundo ambiente público. A produção continua na Vercel, publicada à mão.

  • Amostra pequena

    10 personas × 3 execuções é pouco para cravar uma taxa. Os números mostram a direção, não uma garantia.

  • Teto de gasto

    A demo pública tem US$ 0,07 por dia para o modelo. Quando acaba, o chat avisa e volta no dia seguinte, sem modelo de reserva. Um atendimento resolvido sem analista custa cerca de US$ 0,005 em modelo. Desde 11/11 a sugestão de resposta passa pelo teto e registra o custo; os embeddings e o avaliador de relevância continuam fora do livro-caixa, com menos de US$ 0,001 por conversa (relatório de custos ↗, plano de escala ↗).

  • Chamadas repetidas

    A telemetria mostrou o modelo chamando a tool de entendimento várias vezes em paralelo no primeiro passo. Só a primeira vale, mas as outras gastam tokens.

  • Evals fora do CI

    Rodam à mão porque chamam o modelo real. O próximo passo é rodá-los no CI com um limiar mínimo.

  • Serviços de verdade

    O SSO só foi testado contra um provedor falso, e a telemetria contra um coletor local. Sair não revoga o JWT no servidor, e o console precisa de tela larga.

  • Material com a marca antiga

    O vídeo de demo, a animação da leitura de imagem e a captura do teste da impressora são de antes de 11/11 e ainda mostram o nome Nexo Assist.