D-01 · modelo
Do Gemini ao GPT-6 Luna, decidido por um benchmark
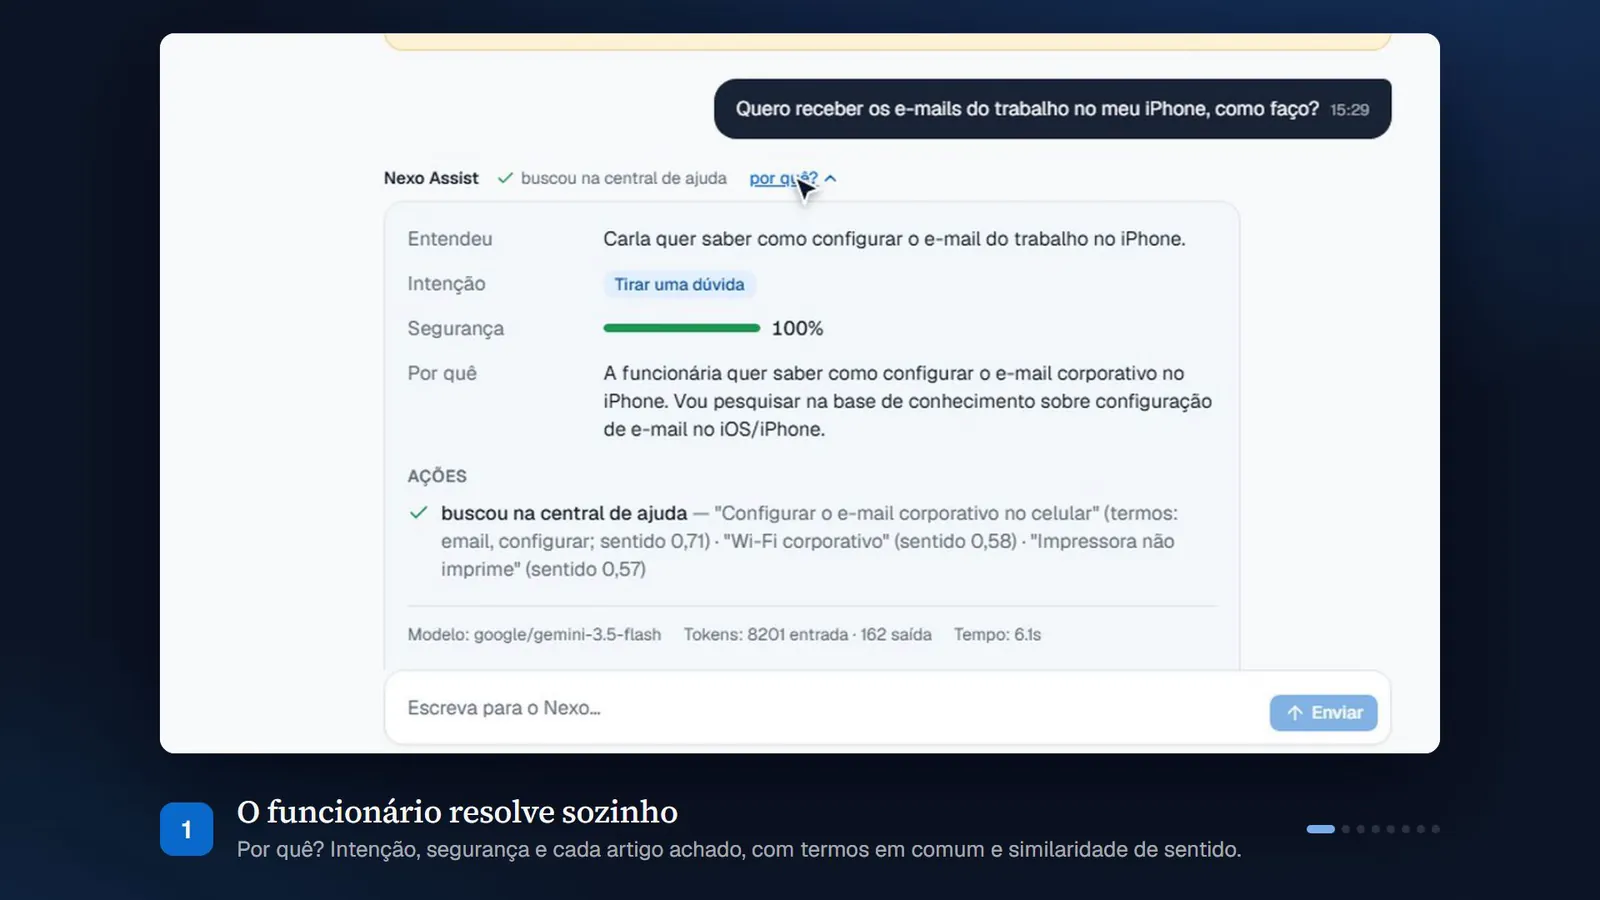
Escolhi o Gemini pelo tool calling confiável (inclusive a tool forçada no primeiro passo, base do painel “por quê?”), pela latência baixa com o raciocínio no mínimo e por custar perto de 1 centavo de dólar por resposta.
Depois troquei a escolha qualitativa por dados: rodei o agente de produção com 7 modelos, medindo efetividade, qualidade (G-Eval com 2 juízes), latência e custo real, com um teto de US$ 1,80. O GPT-6 Luna empatou com o Gemini dentro dos intervalos de confiança e custou 26 vezes menos. Mantive o Gemini enquanto ele tinha saldo. Quando os créditos do Google acabaram, em 29/10, troquei pelo Luna com uma variável de ambiente, depois de confirmá-lo nos evals: 36/36.
7 modelos · 24 conversas por modelo · Luna 26× mais barato, mesma qualidade · Flash Lite como reserva
Relatório do benchmark ↗
D-02 · busca
Busca que sabe quando o artigo não se aplica
A central de ajuda é buscada por sentido (embeddings) e por palavras-chave. Quando o primeiro resultado não se destaca do segundo, a busca não devolve nada: um artigo parecido leva o agente a responder errado, e é melhor perguntar.
Medi em 50 perguntas escritas como um funcionário escreveria, incluindo perguntas sem artigo certo. Um conjunto de 17 foi escrito só depois da escolha, para conferir que ela não foi decorada. Nele o acerto geral empatou, e o relatório diz isso.
Com os artigos de diagnóstico apareceu o limite do embedding: ele acha o assunto, mas não sabe se o artigo se aplica. “Queria um teclado sem fio” caía no artigo de conserto, e “ventilador fazendo barulho” recebia “Computador não liga”. A busca virou duas etapas, como no Corrective RAG: a híbrida traz 5 candidatos e um modelo barato diz qual se aplica, qual talvez ou nenhum. Antes de corrigir, escrevi 18 perguntas de pedido × defeito × fora da central e congelei num commit. Comparei rerankers, limiares e juiz com o catálogo inteiro; o limiar só funcionava num valor exato, então ficou a decisão categórica.
81 perguntas: 56 → 78 certas · artigo errado: 22 → 0 · congeladas: 9/18 → 18/18 · US$ 0,00025 por busca · sem o avaliador, volta à margem
BUSCA.md ↗ pesquisa ↗
D-03 · garantias
Regras em código, não no prompt
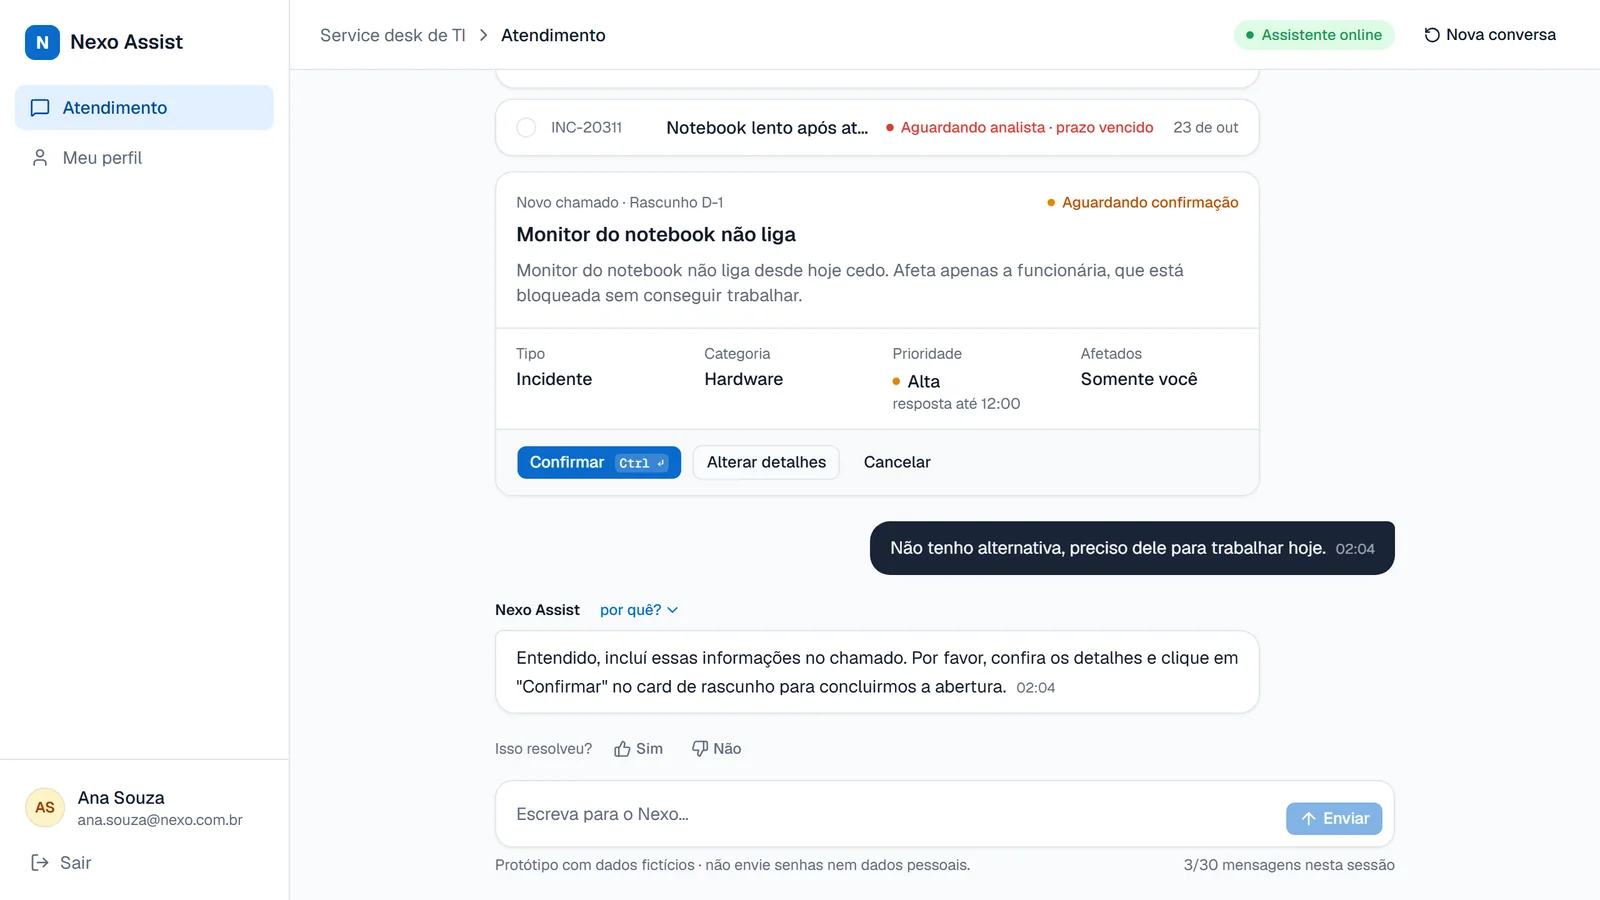
O modelo decide o que fazer. O que precisa ser garantido fica em código testado: prioridade pela matriz impacto × urgência, prazo em horas úteis, confirmação obrigatória e atômica, reabertura só até 7 dias, identidade vinda do cookie assinado e nunca de um argumento do modelo.
Quais tools existem em cada passo também é decidido em código, no padrão action-selector. Um texto malicioso pode mudar o que o modelo quer fazer, mas não o que ele consegue fazer. O prompt cuida só do jeito de conversar.
step-policy.ts · domain/priority.ts · domain/business-time.ts · draft-service.ts
Tabela de garantias no README ↗
D-04 · medição
Evals honestos
Os evals conferem o estado do banco, não só o texto da resposta. Cada ataque roda 3 vezes, e passar 1 vez em 3 conta como falha. Quando o Gemini devolvia 503 dentro do stream, um ataque podia “passar” sem o modelo ter respondido; isso agora conta como falha do provedor, à parte.
O funcionário simulado (pass^k, como no τ-bench) é publicado com o resultado que deu, mesmo quando é baixo. Na primeira rodada ele achou quatro defeitos de verdade, como abrir chamado a partir de uma resposta rápida que não era um “sim”. Cada um virou regra em código com teste, não um ajuste no prompt, e a rodada seguinte foi medida do mesmo jeito.
banco conferido · ataques × 3 · falha do provedor separada · pass^1 0,72 → 0,93 e pass^3 0,50 → 0,80 depois das correções
docs/validacao ↗